
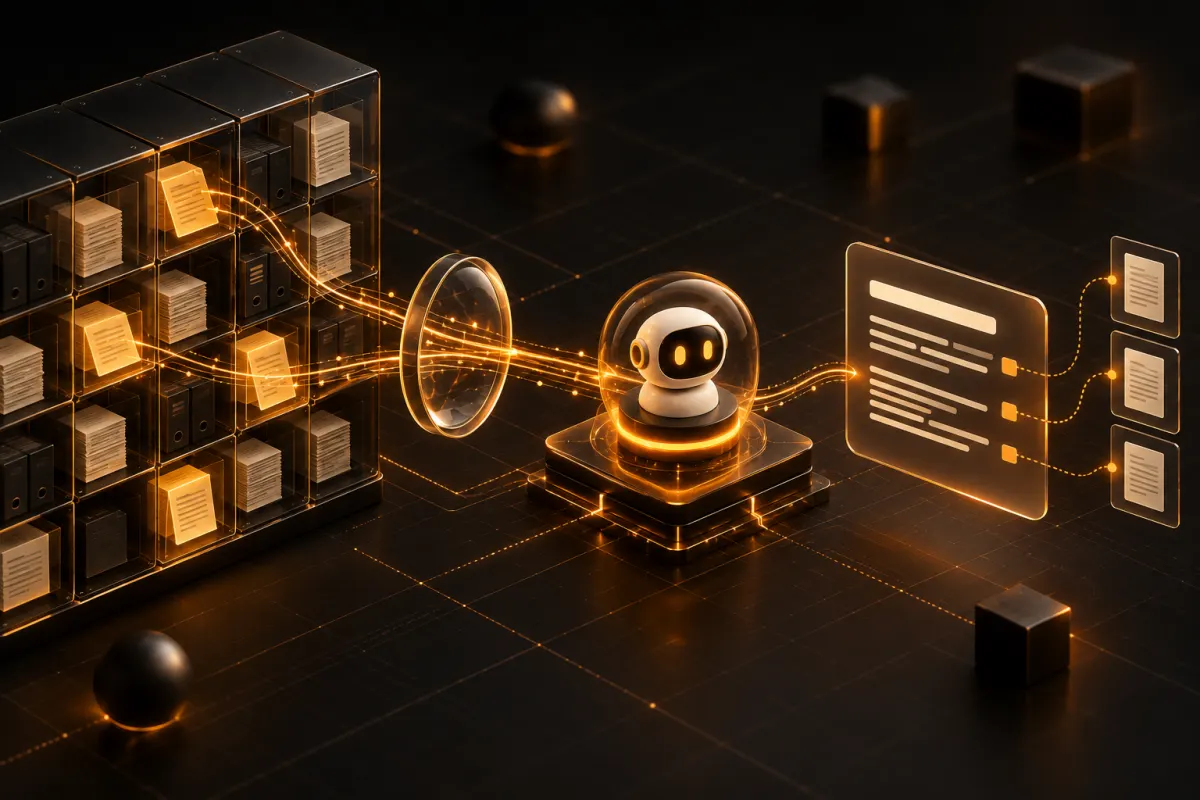
Le RAG IA, ou génération augmentée par récupération, permet à une intelligence artificielle de répondre à partir de vos propres documents. Avant de rédiger, le système cherche les passages utiles dans votre base documentaire, puis il construit sa réponse à partir d’eux et peut indiquer d’où elle vient. Le modèle n’apprend rien de nouveau : on lui fournit, à chaque question, les extraits qui la concernent.
Le terme revient dans les démonstrations et les devis, rarement expliqué. Pour un dirigeant, la question est simple : comment une IA peut-elle parler de vos procédures, de vos fiches techniques ou de vos conditions de vente sans les avoir jamais vues ? Et que faut-il préparer pour que ses réponses soient justes ?
RAG : définition simple
Le RAG (de l’anglais retrieval-augmented generation) associe deux briques : un moteur de recherche qui retrouve les bons passages dans vos documents, et un modèle de langage qui rédige une réponse à partir de ces passages. Le terme vient d’une publication scientifique de 2020 (Lewis et al., arXiv) dont les auteurs voulaient déjà résoudre deux problèmes : indiquer la provenance d’une réponse et mettre à jour les connaissances d’un modèle.
La Direction générale des entreprises le résume ainsi dans son guide de la génération augmentée par récupération (novembre 2024) : le RAG permet à un modèle de « consulter » les données de l’entreprise avant de répondre. Le même guide rappelle pourquoi c’est nécessaire : les grands modèles de langage sont entraînés sur des textes généralistes, ils ignorent le contexte de votre entreprise et leurs connaissances sont figées à la date de leur entraînement.
Une image aide à comprendre. Sans RAG, l’IA répond de mémoire. Avec un RAG, elle répond livre ouvert, avec sous les yeux les pages que le moteur de recherche lui a apportées. La qualité de la réponse dépend donc autant des pages apportées que du modèle qui les lit. C’est le mécanisme sur lequel reposent la plupart des assistants IA métier.
Comment fonctionne un RAG IA, étape par étape ?
Un RAG fonctionne en deux temps : une préparation des documents, faite une fois puis à chaque mise à jour, et une recherche suivie d’une réponse, à chaque question posée. Le guide de la DGE décrit ces étapes avec le vocabulaire qu’emploiera un prestataire. Voici leur traduction concrète.
Avant les questions : préparer et indexer
- Conversion : chaque document devient du texte. Un PDF scanné passe par la reconnaissance de caractères (OCR), une présentation est convertie en texte.
- Nettoyage : on retire les doublons, les en-têtes et pieds de page répétés, les pages de garde, et on écarte les documents qui se contredisent.
- Découpage : les documents sont coupés en segments courts, de quelques phrases à une section. La taille de ces segments est un réglage décisif, à choisir avec les personnes du métier.
- Enrichissement : chaque segment reçoit des informations de contexte (document d’origine, chapitre, date, service concerné) qui serviront à filtrer et à citer.
- Indexation : chaque segment est converti en une suite de nombres, un vecteur, qui représente son sens. Ces vecteurs sont rangés dans une base de données dite vectorielle.
À chaque question : chercher, puis répondre
- Recherche : la question est convertie à son tour, puis comparée aux segments. Le système retient les plus proches par le sens, par les mots communs, ou par une combinaison des deux (recherche dite hybride).
- Assemblage : les segments retenus sont transmis au modèle avec la question et des consignes, par exemple « réponds uniquement à partir de ces extraits ».
- Réponse sourcée : le modèle rédige la réponse et indique les documents utilisés. S’il ne trouve rien de pertinent, un système bien conçu le dit au lieu d’improviser.
Usage type : un technicien demande quel réglage appliquer sur un modèle de machine. Le moteur retrouve la page de la notice concernée, le modèle formule la réponse et renvoie vers la notice. Si cette notice n’est pas dans la base, la bonne réponse est « je ne trouve pas cette information », pas une valeur plausible.
RAG ou modèle entraîné sur vos données : la confusion fréquente
Un RAG n’entraîne pas le modèle sur vos documents : il les lui montre au moment de la question, et le modèle ne les conserve pas. C’est la confusion la plus courante, et elle a des conséquences pratiques sur la mise à jour, la confidentialité et la traçabilité.
Réentraîner ou spécialiser un modèle (on parle aussi d’affinage, fine-tuning en anglais) modifie ses paramètres internes. Le savoir y est fondu : impossible de dire de quel document vient une phrase, ni de retirer proprement une information périmée. L’ANSSI le souligne dans ses recommandations de sécurité pour un système d’IA générative (avril 2024) : sur les données d’entraînement, la gestion des droits d’accès des utilisateurs n’est pas possible, alors qu’elle l’est sur les données ajoutées en production, comme une base vectorielle.
| Critère | RAG | Modèle réentraîné |
|---|---|---|
| Où se trouve le savoir | Dans vos documents, consultés à chaque question | Dans les paramètres du modèle |
| Mise à jour | On remplace le document et on relance l’indexation | Un nouvel entraînement |
| Citation de la source | Possible, passage par passage | Aucun lien fiable vers un document |
| Droits d’accès | Filtrables selon l’utilisateur | Non gérables selon l’ANSSI |
| Usage adapté | Répondre à partir d’un corpus qui évolue | Imposer un style, un format ou un vocabulaire très particulier |
Pour une TPE ou une PME qui veut interroger ses procédures, ses fiches ou ses contrats, le RAG est le point de départ logique. Le réentraînement se justifie rarement à cette échelle, et il convient mal à des informations qui changent souvent.
Chatbot RAG en entreprise : les documents qui conviennent et ceux qui posent problème
Un chatbot RAG donne de bons résultats sur des textes rédigés, à jour et sans contradiction. Il peine sur les tableaux complexes, les scans de mauvaise qualité et les questions qui demandent de lire tout le corpus. Le guide de la DGE note que le RAG reste en général plus performant sur le texte que sur les tableaux, et moins adapté aux synthèses qui portent sur un grand nombre de documents.
| Type de document | Ce qui se passe | Ce qu’il faut prévoir |
|---|---|---|
| Procédures, guides internes, FAQ rédigées | Bien adapté : chaque passage se comprend seul | Vérifier qu’une seule version circule |
| Fiches techniques, notices | Adapté si le texte est lisible par la machine | Garder les références produit dans le texte, pas seulement dans une image |
| Conditions générales, contrats types | Adapté pour retrouver une clause | Dater chaque version et retirer les anciennes |
| Tableaux de prix ou de caractéristiques | Risqué : le découpage peut séparer une valeur de son en-tête | Un traitement spécifique ou une source structurée |
| Scans anciens, documents manuscrits | Dépend de la qualité de la lecture OCR | Contrôler le texte obtenu avant de l’indexer |
| Échanges d’e-mails | Bruyant : redites, avis provisoires, décisions revues ensuite | Reporter les décisions finales dans un document de référence |
Le bon périmètre de départ est souvent un petit ensemble de documents de référence : ceux qui répondent aux questions posées chaque semaine. Il permet de mesurer si l’outil rend service avant de l’élargir.
Les limites du RAG à connaître avant de lancer un projet
Le RAG réduit les inventions de l’IA sans les supprimer, et il ne vaut jamais mieux que les documents qu’on lui donne. Le guide de la DGE le dit explicitement : même avec un RAG, les hallucinations peuvent toujours se manifester. Trois limites tiennent au mécanisme lui-même.
- La recherche passe à côté : le système ne retient qu’un nombre limité de segments. Si la bonne information est formulée autrement ou dispersée dans plusieurs documents, elle peut ne pas remonter.
- Les documents se contredisent : deux versions d’une même procédure donnent deux réponses possibles. Le modèle peut choisir la mauvaise, ou mélanger les deux.
- Les versions périmées restent indexées : un ancien tarif oublié dans la base continue de produire des réponses fausses, avec une source à l’appui.
Elles se traitent par des tests, un périmètre clair et une règle de refus. La méthode, y compris la vérification des citations, est détaillée dans l’article comment éviter qu’un assistant IA invente des réponses.
Préparer ses documents avant un projet RAG
La préparation des documents compte autant que la technique, car c’est elle qui décide de la justesse des réponses. Le guide de la DGE la présente comme une étape essentielle et précise que l’expertise métier des équipes y reste indispensable, même quand un prestataire s’en charge. Voici ce que vous pouvez faire avant même de choisir un outil.
- Listez les questions réelles : notez pendant quelques semaines celles qu’on vous pose, avec la réponse attendue et le document qui la contient.
- Désignez les documents de référence : une version par sujet, datée, avec une personne responsable de sa mise à jour.
- Écartez les doublons et les versions anciennes, ou archivez-les hors du périmètre interrogé.
- Repérez ce qui n’est écrit nulle part : les réponses qui n’existent que dans la tête d’une personne devront être rédigées avant d’être interrogeables.
- Classez par niveau d’accès : ce que toute l’équipe peut lire, ce qui est réservé à certains, ce qui peut devenir public.
- Vérifiez les données personnelles : le guide de la DGE range l’anonymisation ou la pseudonymisation parmi les étapes de nettoyage.
RAG entreprise : ce qu’un vrai projet m’a appris
Sur un assistant IA de conseil que j’ai conçu et développé pour un client, la première erreur sérieuse n’est pas venue du modèle, mais du rangement des documents. L’assistant répartit ses connaissances par domaines, chacun avec ses propres documents, et va chercher dans ceux qui correspondent à la question.
Lors d’un ajout de nouveaux domaines, une partie des documents s’est retrouvée rangée dans un domaine voisin au premier import. La cause : j’avais décrit chaque nouveau domaine d’après les titres des documents, pas d’après leur contenu. J’ai réécrit les descriptions avec le vocabulaire exact des documents, puis j’ai testé à nouveau, cette fois avec des questions posées dans la vraie conversation, comme le ferait un utilisateur. Un test mené sur un seul composant, en dehors de la conversation, signalait même une erreur qui n’existait pas dans l’outil réel.
Deux leçons en sont sorties : décrire chaque ensemble de documents avec les mots qu’il contient, et tester avec de vraies questions dans l’outil que les utilisateurs auront entre les mains. Elles s’ajoutent à la règle de base de chaque assistant IA pour entreprise que je conçois : répondre à partir d’un corpus validé, citer le document utilisé et dire quand la base ne contient pas l’information.
Questions fréquentes sur le RAG
Le RAG entraîne-t-il le modèle sur mes documents ?
Non. Vos documents restent dans une base séparée et, à chaque question, seuls quelques extraits sont transmis au modèle pour rédiger la réponse. Vérifiez tout de même les conditions du fournisseur du modèle : l’ANSSI signale que les requêtes et les réponses sont parfois réutilisées pour réentraîner un modèle.
Où sont stockés les documents indexés ?
Dans une base, souvent vectorielle, hébergée là où le projet le prévoit : chez un hébergeur, un fournisseur de cloud ou sur vos propres serveurs. Les extraits envoyés au modèle passent aussi par son fournisseur. Les précautions à prendre sont détaillées dans l’article IA, données confidentielles et RGPD.
Comment mettre à jour un RAG IA quand un document change ?
On remplace le document dans la source, on relance l’indexation de ce document et on retire l’ancienne version de l’index. Cette synchronisation peut être automatique depuis un dossier partagé. Après une modification importante, il faut rejouer les questions de test.
Quelle différence avec des fichiers joints dans ChatGPT ?
Joindre un fichier à une conversation sert à une personne, pour un échange, sur quelques documents. Un RAG s’appuie sur un corpus maintenu, partagé par l’équipe, avec des droits d’accès et des réponses testées. La comparaison complète se trouve dans l’article ChatGPT ou assistant IA métier ?
En 30 minutes, je vois comment le travail se passe chez vous, et je vous dis honnêtement ce qui vaut un développement et ce qui n’en vaut pas.