
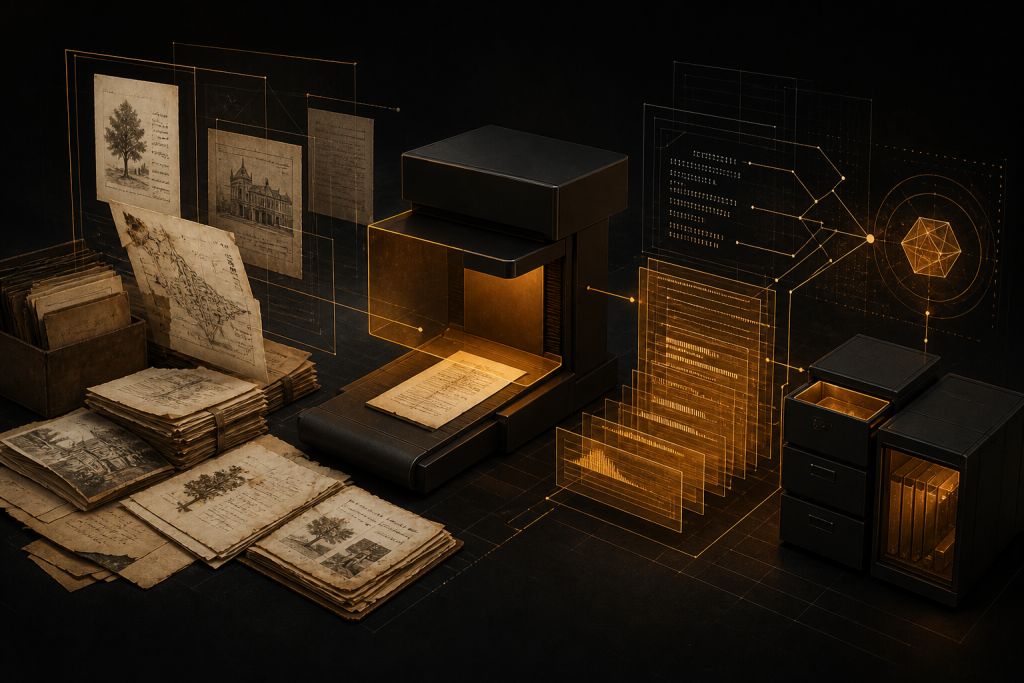
L’OCR de documents (reconnaissance optique de caractères) transforme l’image d’un texte en caractères que l’ordinateur peut rechercher, copier et traiter. Il rend un scan lisible par la machine, mais il ne range pas l’information : pour exploiter des PDF scannés, des images ou des archives, il faut encore garder le lien avec l’original, structurer les champs utiles et vérifier les cas incertains.
Numériser n’est pas encore lire
Scanner un document protège le support et facilite sa circulation. Cela ne transforme pas son contenu en données : une image rangée dans un dossier reste impossible à rechercher ou à comparer. Beaucoup d’entreprises ont ainsi des milliers de scans bien nommés, et ouvrent encore les fichiers un par un pour retrouver une référence ou une date.
La confusion vient de quatre opérations différentes, souvent regroupées sous le mot « numérisation » :
- numériser crée une image du document ;
- l’OCR reconnaît les caractères de cette image ;
- l’indexation permet de retrouver le document par son contenu ou ses métadonnées ;
- la structuration transforme certains éléments en champs utilisables : une date, un montant, une référence.
L’OCR n’est que la deuxième étape. Si votre besoin est de remplir un tableau à partir de PDF, l’article sur l’extraction de données d’un PDF vers Excel traite la suite de la chaîne.
Pour quelques scans, un OCR gratuit suffit
Pour rendre lisibles quelques pages, inutile d’investir. Google Drive, par exemple, fait de l’OCR : clic droit sur le PDF ou l’image, puis Ouvrir avec Google Docs. Google pose des conditions précises : un fichier de 2 Mo au plus, un texte d’au moins 10 pixels de haut, un document dans le bon sens, net et bien contrasté. Google prévient aussi que les listes, tableaux et colonnes ont peu de chances d’être détectés.
Ces limites résument bien celles de l’OCR en général : il restitue du texte, rarement la structure. Et confier un document à un service en ligne reste une décision à prendre au regard de sa confidentialité.
Ce qui fait chuter la qualité de l’OCR
La BnF décrit une chaîne en trois temps : prétraitement de l’image, segmentation de la page, reconnaissance des caractères. Elle souligne l’impact du contraste, de l’orientation, des bavures, des mises en page en colonnes et des illustrations. Un tampon sur un chiffre, une page photographiée de biais ou une photocopie de photocopie suffisent à produire des erreurs.
Il existe aussi une limite que l’image n’explique pas : reconnaître « 12,4 » ne dit pas s’il s’agit d’une mesure, d’une référence ou d’un numéro de page. La lecture des caractères et la compréhension du document sont deux étapes distinctes, et la seconde dépend de vos règles métier.
C’est pourquoi je sépare les deux cas dès le devis. Sur un projet de lecture de fiches de données de sécurité pour un bureau d’études, la réserve était écrite noir sur blanc : les PDF qui contiennent du texte sont lus directement, les vieux scans passent par l’OCR en secours, sans garantie de lecture complète, et chaque doute est signalé plutôt que comblé. Dans un outil en service chez un bureau d’études, l’OCR lit des relevés de mesure faits sur le terrain pour alimenter le suivi des mesures.
De l’image archivée à la donnée exploitable : cinq niveaux
| Niveau | Ce qui devient possible | Ce qui manque encore |
|---|---|---|
| 1. Fichier conservé | Ouvrir le document si son emplacement est connu | Recherche dans le contenu et contexte fiable |
| 2. Texte reconnu | Rechercher des mots après OCR | Structure, correction des erreurs et lien entre une valeur et son rôle |
| 3. Document indexé | Filtrer par type, date, dossier ou entité | Champs métier comparables entre documents |
| 4. Données structurées | Trier, comparer, exporter et alimenter une application | Règles de qualité, exceptions et preuve de l’origine |
| 5. Données contrôlées | Déclencher un workflow avec une revue ciblée des cas incertains | Suivi continu des erreurs, versions et nouveaux formats |
Toutes les archives n’ont pas besoin du niveau 5. Pour retrouver un dossier, le niveau 3 suffit. Pour comparer des valeurs entre documents, il faut le niveau 4. Choisissez le niveau d’après ce que vous ferez de l’information, et gardez toujours le lien vers l’image d’origine pour vérifier une donnée importante.
À partir du niveau 4, une file de vérification devient indispensable : page illisible, document incomplet, écriture manuscrite, tableau atypique ou date impossible doivent être mis de côté pour une personne, pas intégrés en silence. Pour passer de vos scans à un tableau ou une base contrôlée, je mets en place une extraction de données de documents qui garde le lien vers chaque page source.
Questions fréquentes
L’OCR de documents suffit-il pour interroger des archives ?
Non. Il fournit du texte. Il faut encore indexer ce texte, gérer les métadonnées, les droits d’accès et le lien vers la source.
Faut-il corriger toutes les erreurs manuellement ?
Pas nécessairement. On peut concentrer la relecture sur les champs critiques et sur les résultats dont le niveau de confiance est faible.
Peut-on traiter des tableaux et des formulaires ?
Oui, mais leur structure doit être testée sur les différentes variantes. Une ligne décalée peut changer le sens d’une valeur.
Doit-on supprimer les fichiers originaux ?
Non. L’original reste la référence à conserver selon vos obligations et votre politique d’archivage. Les données extraites constituent une couche d’exploitation supplémentaire.
Vos archives sont numérisées mais personne ne s’en sert ? Quelques documents représentatifs suffisent pour voir jusqu’à quel niveau il est raisonnable d’aller.